Fem missförstånd om AI som kommer upp på varje utbildning
AI tränas på allt du skriver, ditt dokument kan dyka upp hos någon annan och den måste vara felfri för att duga. Fem missförstånd vi möter på nästan varje utbildning och vad som verkligen stämmer.
Vissa frågor kommer på varje utbildning, oavsett om deltagarna är ekonomer, jurister eller kommunikatörer. Tränas AI på det jag skriver in? Kan mitt dokument dyka upp hos någon annan? Är det inte oansvarigt att låta Copilot läsa våra filer?
Frågorna är rimliga, för svaren står sällan samlade på ett ställe. Här är de fem missförstånd vi möter oftast, vad som verkligen stämmer och vad du kan göra själv.
Kortversionen
- Missförstånd: AI lär sig av min chat direkt.
Fakta: Modellen du chattar med är färdigtränad. Din chat kan bli träningsdata först när nästa modell byggs och bara om din inställning eller ditt avtal tillåter det. - Missförstånd: Mitt dokument kan dyka upp hos någon annan.
Fakta: Filen ligger krypterad i ditt konto. Det som läcker beror nästan alltid på mänskliga faktorn: delningslänkar, privatkonton och öppna behörigheter. - Missförstånd: Med Copilot tappar vi kontrollen över känslig information.
Fakta: Filerna ligger redan hos Microsoft under ert avtal. Copilot läser dem inom samma gräns och visar bara det du redan får se. - Missförstånd: Varje fråga till ChatGPT kräver enorma resurser.
Fakta: En typisk fråga drar under en halv wattimme. Det som växer är helheten, så det avgörande är vad du använder AI till. Mer värdefullt arbete, mindre roliga kattfilmer. - Missförstånd: AI ljuger och går inte att lita på.
Fakta: Modeller gissar ibland när de saknar svar, och det sker allt mer sällan. Ge modellen bra kontext, kräv källor och granskning så minimeras problemet.
AI lär sig av allt jag skriver in
Missförstånd
Så fort jag skriver något i ChatGPT eller laddar upp ett dokument lär sig modellen det direkt, och nästa person som frågar får nytta av min data.
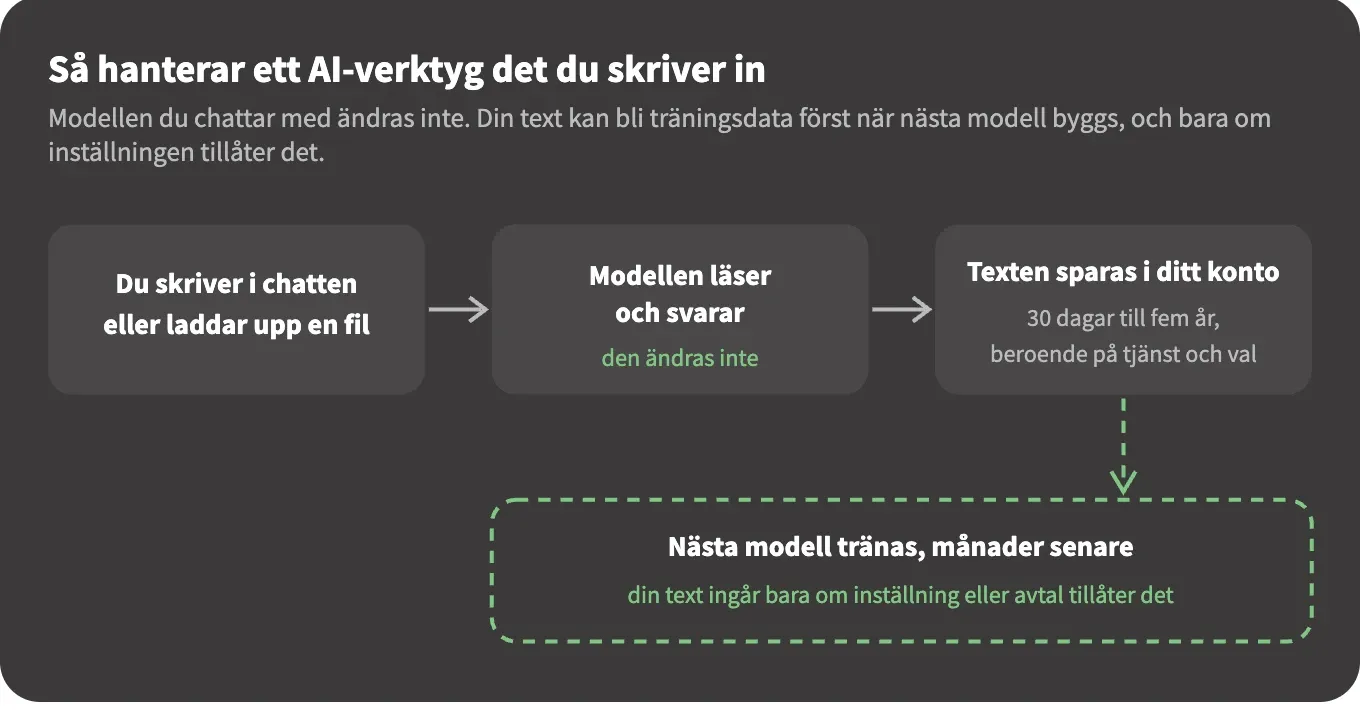
Fakta: Modellen du chattar med är färdigtränad när du möter den. Bakom missförståndet ligger bilden av en spion som lyssnar och antecknar medan du skriver. En språkmodell fungerar på ett annat sätt.
Den byggs i två skilda steg. Det första kallas träning: modellen läser enorma mängder text i veckor eller månader, i en enda omgång, långt innan du får tillgång till den. Bokstaven P i GPT står för pre-trained, förtränad. OpenAI beskrev metoden redan 2018 som två idéer i kombination: transformer-arkitekturen, den modellstruktur dagens språkmodeller fortfarande bygger på, och oövervakad förträning. När omgången är klar fryses modellen.
Det andra steget kallas inferens, och det är det som sker när du chattar. Modellen läser din text, räknar fram ett svar och behåller ingenting av den. Modellen är exakt likadan efter din chat som före.
Din chat kan ändå bli träningsdata. Det sker i så fall i en senare omgång, när nästa modell byggs månader bort, och bara om leverantören har rätt att använda den. Den rätten styrs av dina inställningar, och de skiljer sig åt mellan tjänsterna.
Den andra halvan av missförståndet handlar om minne. Invändningen låter: ChatGPT kommer ihåg att jag har hund, alltså lär den sig om mig i smyg. Minnet är en vanlig funktion med ett öppet register. Minnet i ChatGPT går att läsa och radera post för post under inställningarna, och du kan stänga av det helt.
Claude listar sina minnen ämne för ämne under Settings och låter dig redigera eller radera varje ämne. Gemini har en motsvarande minnesväxel. Copilot samlar sina under Personalization, med en knapp som raderar allt. Det modellen vet om dig står i en lista du själv kan öppna.
Så stänger du av träning på dina data
Menyerna står ofta på engelska även i svenska konton.
ChatGPT: Settings, Data Controls, stäng av "Improve the model for everyone". I Business, Enterprise och API tränas inget på som standard. Temporary Chat sparas inte i historiken, tränas inte på och raderas efter 30 dagar.
Claude: Sedan den 28 augusti 2025 tränar Anthropic på chattar i Free, Pro och Max om du inte stänger av det under Privacy Settings. Med träning på sparas de i upp till fem år, med träning av i 30 dagar. Claude for Work, Education, Government och API omfattas inte.
Gemini: Inställningen heter Keep Activity. På: chattar och uppladdade filer används för att förbättra Googles tjänster, inklusive AI-modellerna, och en del läses av mänskliga granskare. Av: framtida chattar tränas inte på och raderas efter 72 timmar, men det som redan lästs av granskare sparas frikopplat från kontot i upp till tre år.
Copilot i Microsoft 365: Inget att stänga av. Microsoft anger att prompter, svar och data som hämtas via Microsoft Graph, indexet över allt ni har i Microsoft 365, inte används för att träna grundmodellerna.
Mitt dokument kan dyka upp hos någon annan
Missförstånd
Laddar jag upp vår affärsplan kan en konkurrent fråga ChatGPT om den i morgon.
Fakta: När du laddar upp ett dokument i ett AI-verktyg lagras det på leverantörens servrar, som en fil, krypterat och knutet till ditt konto. Det måste det, för att verktyget ska kunna arbeta med filen. Hur länge det ligger kvar styr tjänstens lagringsregler, precis som för ett mejl eller en fil i Dropbox.
Under chatten läser modellen filen i småbitar, så kallade tokens, och behåller ingenting av den. Din konkurrent har ingen väg in i ditt konto, och modellen som svarar konkurrenten är samma färdiga modell som svarar dig.
Dokument läcker på andra sätt: genom människor och inställningar. Tre verkliga fall, varav två i dag är till stor del täppta:
- Delningslänkar som blev sökbara. Sommaren 2025 kunde vem som helst hitta nära 4 500 delade ChatGPT-konversationer via Google, avslöjade Fast Company. Användarna hade själva kryssat i att chatten fick indexeras, ofta utan att förstå vad det innebar. OpenAI tog bort kryssrutan dagen efter.
- Privat konto för jobbmaterial. Samsung förbjöd 2023 sina anställda att använda ChatGPT efter att ingenjörer klistrat in källkod och mötesanteckningar i vanliga privatkonton. Bolaget angav tre skäl: data låg på externa servrar, den var svår att hämta tillbaka och radera, och den kunde hamna hos andra användare. Det tredje var rimligt då. Våren 2023 använde ChatGPT chattar i privatkonton för träning som standard, och möjligheten att stänga av det kom först i slutet av april, veckor efter incidenterna. Vägen in var kontotypen och dess inställning.
- Egna behörigheter som ingen städat. Copilot visar bara sådant du redan har läsrättigheter till i Microsoft 365, enligt Microsofts dokumentation. Problemet är att många organisationer har SharePoint-mappar som råkar vara öppna för alla. Det syntes inte förut eftersom ingen letade. Nu letar Copilot.
De två första vägarna är smalare i dag. Rutan som gjorde delade länkar sökbara finns inte längre, och träningsvalet finns i varje privatkonto sedan 2023. Den tredje är högst levande. Den avgör om Copilot kan rullas ut utan att gamla behörighetsfel blottas.
Gemensamt för alla tre: filen låg där någon kunde nå den. Var filen ligger, vem som har nyckeln och vad som råkade vara öppet avgör, varje gång.
Så skyddar du dokument du laddar upp
Använd ett konto där arbetsgivaren är kund, inte du själv: ChatGPT Business, Claude Team eller Copilot inom er Microsoft 365-licens. Där styr ett avtal i stället för en inställning. Dela inte chattar med länk när innehållet är känsligt. På organisationsnivå: be IT göra en behörighetsgenomgång i SharePoint innan Copilot rullas ut. Vad som gäller juridiskt reder vi ut i guiden om AI och regelverk.
Slår vi på AI läcker våra data
Missförstånd
Med Copilot tappar vi kontrollen över känslig information.
Fakta: Filerna ligger redan hos Microsoft. Har organisationen OneDrive, SharePoint, Teams och Exchange Online är varje dokument, chat och mejl redan i Microsofts moln, under det avtal ni tecknade när ni flyttade dit. Beslutet om var informationen bor togs den dagen.
Copilot ändrar vad som kan göras med filerna, inom samma gräns. En modell läser dem för att svara på din fråga, och den visar bara sådant du redan har rätt att se. Prompter, svar och data via Microsoft Graph stannar hos er. Enligt Microsofts dokumentation används de inte för att träna grundmodellerna.
Modellerna är i huvudsak OpenAI:s, som Microsoft anlitar som underbiträde med sina egna produktvillkor och sitt eget personuppgiftsbiträdesavtal som grund. Vem som byggt modellen spelar därför mindre roll än man tror. Trafik från EU-användare stannar dessutom inom EU Data Boundary, Microsofts åtagande att behandla EU-kunders data inom EU.
Två förbehåll hör till bilden och de gäller lika mycket för OneDrive som för Copilot. Det första är amerikansk lag. I juni 2025 fick Anton Carniaux, chef för samhällskontakter och juridik på Microsoft Frankrike, frågan i den franska senaten om han kunde garantera att franska medborgares data aldrig lämnas ut till amerikanska myndigheter utan franskt godkännande. Svaret var nej, det kan han inte, med tillägget att det aldrig har hänt.
Lagen bakom heter CLOUD Act. Den låter amerikanska myndigheter begära ut data från amerikanska bolag oavsett var servern står, och den träffar allt i molnet.
Det andra förbehållet gäller Anthropics modeller, som Microsoft också erbjuder i Copilot. De är undantagna från EU Data Boundary och därför avstängda som standard för kunder inom EU. Först när er administratör aktivt slår på dem lämnar trafiken EU-gränsen.
Frågan är alltså om molnbeslutet ni redan tagit håller. Håller det, är Copilot en funktion ovanpå. Håller det inte, är det molnet som ska omprövas.
Så prövar ni Copilot mot det molnval ni redan gjort
Ta fram ert befintliga avtal med Microsoft och läs vad som redan gäller för lagring och EU Data Boundary. Låt administratören välja vilka modeller Copilot får använda. Lägg oron där den hör hemma: i behörigheter och i det molnval ni redan gjort.
AI slukar el och vatten
Missförstånd
Varje fråga till ChatGPT kräver enorma resurser, så vi bör hålla igen.
Fakta: En typisk textfråga drar under en halv wattimme och ungefär en kvarts milliliter vatten enligt Googles mätning av Gemini, och elen motsvarar mindre än nio sekunder tv. Frågan är en av dem vi får oftast, så ofta att vi gjort en egen genomgång av AI:s energi- och vattenförbrukning med källor.
Det som växer är helheten, för el och vatten båda två. Världens datacenter väntas mer än fördubbla sin elförbrukning till 2030 enligt Internationella energiorganet IEA, med AI som den viktigaste drivkraften.
Det avgörande är vad frågan ersätter. Kattbilder på skoj är svåra att försvara oavsett hur få wattimmar de drar. Att låta AI korta två timmars rapportskrivande till en halvtimme är en effektivisering, och vinsten är verklig om de sparade timmarna används till något.
Människan bakom rapporten bor, äter och pendlar lika mycket oavsett vem som skriver den. Det som går att spara är tiden och det fysiska flödet runt uppgiften. Den rimliga frågan är vad tiden går till.
AI ljuger och går inte att lita på
Missförstånd
AI hittar på saker, alltså går den inte att använda på jobbet.
Fakta: Modeller hittar på saker, och de kommer att fortsätta göra det. Branschen kallar det hallucinationer, ett ord vi undviker eftersom modellen inte upplever någonting. Den räknar fram det mest sannolika nästa ordet, och när den saknar svar gissar den.
Gissandet är inbyggt. Både träningen och de tester modellerna mäts mot belönar en gissning högre än ett "jag vet inte". Det här visar tre OpenAI-forskare och en forskare vid Georgia Tech i en studie från september 2025. Därför når felen aldrig noll.
De har däremot minskat kraftigt. I OpenAI:s eget faktatest av två mindre modeller svarade den äldre fel på 75 procent av frågorna och den nyare på 26 procent. Den nyare har ungefär lika många rätt, men mycket färre fel, för att den lärt sig säga att den inte vet.
Jämför med hur vi hanterar bilförare. Enligt Världshälsoorganisationen WHO dog 1,16 miljoner människor i trafiken under 2025. Ändå kör vi ut på vägarna varje morgon, eftersom vi byggt ett system runt föraren: körkort, bilbälten, hastighetsgränser och besiktning.
Självkörande bilar döms samtidigt efter varje enskild olycka. Robottaxibolaget Waymo har kört mer än 350 miljoner kilometer utan förare. I juni 2026 rapporterade bolaget 94 procent färre olyckor med allvarliga eller dödliga skador än mänskliga förare i samma områden under samma period. Det är bolagets egna siffror och de gäller amerikanska städer, men riktningen är svår att avfärda.
Samma sak gäller på kontoret. Vi kräver noll fel av AI men accepterar att en kollega missar en siffra. Ge AI:n samma villkor: be om källor, låt den granska sitt eget svar och läs igenom innan det går vidare. Då blir felen hanterbara.
Arbetsflödet runt AI:n ska ta höjd för fel, precis som arbetsflödet runt en människa. Skillnaden är utsikten till betydligt färre av dem.
Vad de fem har gemensamt
Alla fem missförstånd har samma rot. Vi föreställer oss AI som en person som lyssnar, minns och sprider, när det är ett verktyg med inställningar, avtal och gränser som går att läsa.
Den som förstår hur verktyget fungerar lägger oron där den hör hemma: på konton, behörigheter och granskning. Det är där vi lägger tiden i våra kurser, oavsett om deltagarna är ekonomer, jurister eller kommunikatörer.